유전적 연속성은 DNA의 정보 저장과 전달에 기초한다
1.1 DNA는 염기 서열에 정보를 저장하는 고분자다
DNA(deoxyribonucleic acid)는 데옥시리보스, 인산, 질소 염기로 이루어진 뉴클레오타이드가 공유 결합으로 연결된 고분자다. 뉴클레오타이드들은 당의 3′-OH와 다음 뉴클레오타이드의 5′-인산 사이에 인산다이에스터 결합을 형성한다. 이 때문에 DNA 가닥에는 5′ 말단과 3′ 말단이라는 방향성이 존재한다. 유전정보의 기본적인 표현은 아데닌(A), 티민(T), 구아닌(G), 사이토신(C)이 배열된 순서다.
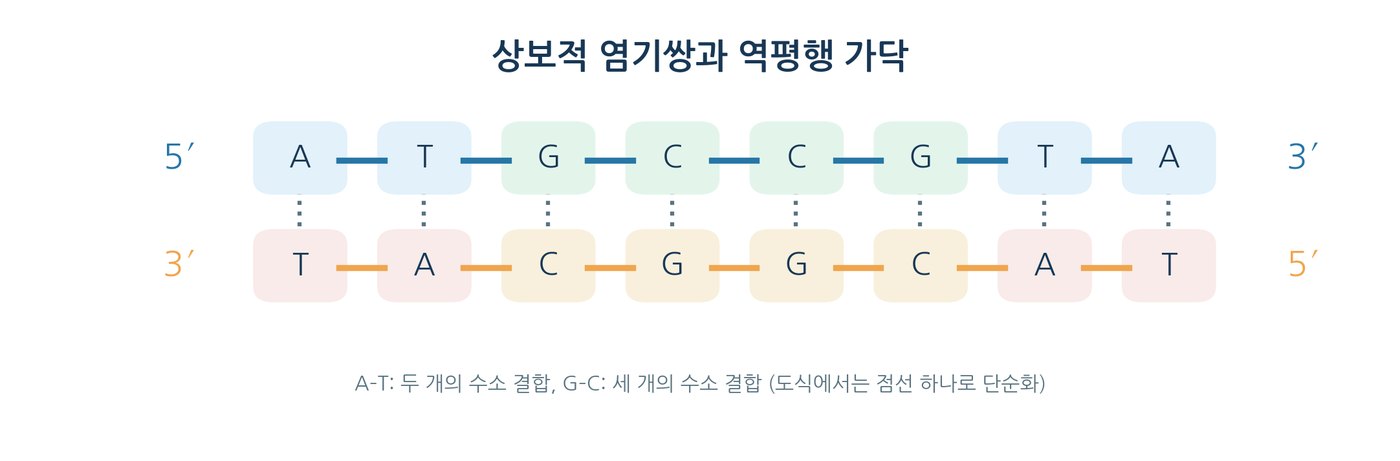
이중나선의 두 가닥은 서로 반대 방향으로 놓인다(역평행, antiparallel). 일반적인 왓슨–크릭 염기쌍에서는 A와 T, G와 C가 상보적으로 결합한다. A–T 사이에는 대표적으로 두 개, G–C 사이에는 세 개의 수소 결합이 형성된다. 이중나선의 안정성은 이러한 수소 결합뿐 아니라 염기 쌓임(base stacking) 등 여러 상호작용에 의해 결정된다.
계산 예제 | 상보적 가닥을 5′→3′로 쓰기
주어진 가닥이 5′-A T G C C G T A-3′라면, 반대쪽은 3′-T A C G G C A T-5′가 된다.
반대쪽 가닥을 5′→3′ 방향으로 다시 표시하려면 순서를 뒤집어 5′-T A C G G C A T-3′로 적는다. 상보 서열과 역상보 서열(reverse complement)을 구별해야 한다.
1.2 유전자, 염색체, 유전체는 서로 다른 수준의 개념이다
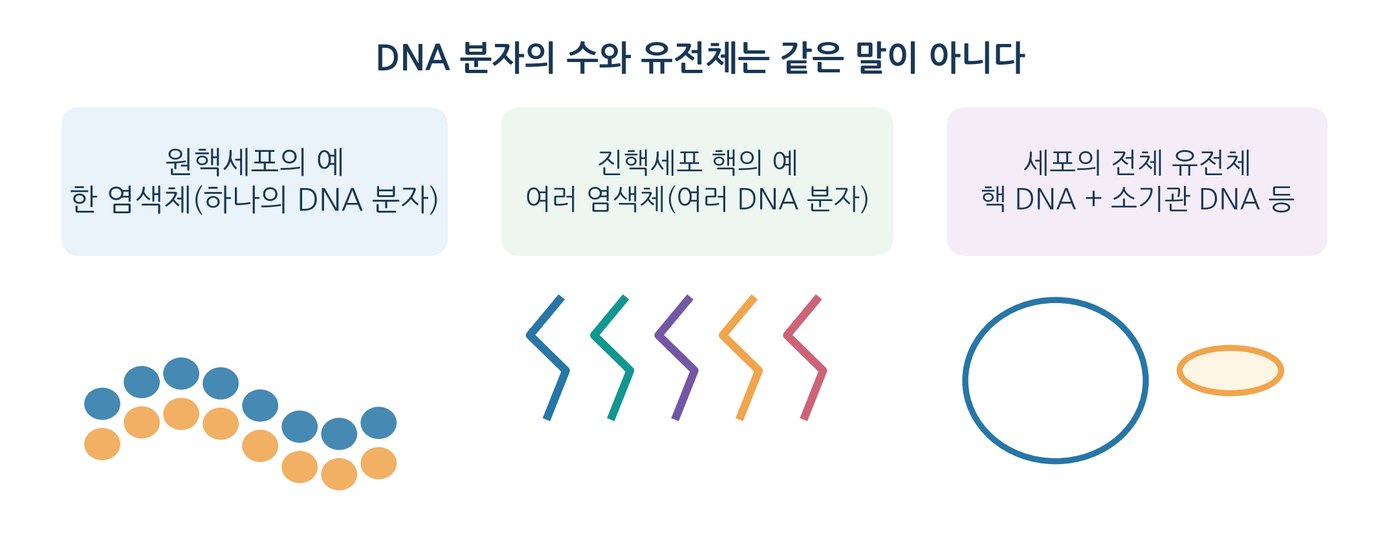
유전자(gene)는 기능을 수행하는 RNA 또는 단백질 산물의 생성과 관련된 DNA 서열을 말한다. 모든 유전자가 단백질을 암호화하는 것은 아니다. 염색체(chromosome)는 DNA와 관련 단백질 등이 조직화된 유전정보의 물리적 단위다. 한 개의 복제 전 염색체는 보통 하나의 연속된 이중가닥 DNA 분자로 이루어진다. 유전체(genome)는 한 생물체 또는 세포에 속한 전체 유전정보의 집합을 뜻한다.
많은 세균은 하나의 원형 염색체를 가지지만, 복수 염색체를 가지는 세균도 있고 플라스미드가 함께 존재하기도 한다. 사람의 일반적인 이배체 체세포는 G1기 핵에 46개의 선형 염색체(46개의 염색체 DNA 분자)를 갖는다. 사람의 미토콘드리아에도 별도의 DNA가 존재한다. DNA가 복제된 뒤에는 각 염색체가 두 자매염색분체를 포함하므로 DNA 분자의 수와 ‘염색체 수’의 관계를 세포주기에 따라 구별해야 한다.
1.3 DNA 서열은 세포 분열과 생식 과정에서 이어진다
세포가 분열하기 전에 DNA를 복제하는 이유는 새로 생기는 세포들에 유전정보를 전달하기 위해서다. 원래의 염기 서열은 상보적인 새로운 가닥을 만드는 주형으로 사용된다. 세포 분열에서 염색체가 적절하게 분배되면 두 딸세포는 원칙적으로 부모 세포의 정보를 물려받는다. 유성생식에서는 감수분열의 재조합과 염색체 분리, 수정 과정이 부모에게서 온 유전정보를 새로운 조합으로 이어 준다.
유전적 연속성은 “완전한 불변”을 뜻하지 않는다. DNA 복제 과정의 오류, 손상 및 복구 실패로 변이가 남을 수 있다. 한편 변화가 존재하기 때문에 개체와 집단에는 유전적 다양성이 생기고, 생물의 진화에 필요한 변이의 원천도 마련된다. 정확한 보존과 드문 변화는 유전체의 두 가지 중요한 특징이다.
DNA는 높은 정확도로 복제되고 지속적으로 복구된다
2.1 DNA 복제는 반보존적 방식으로 진행된다
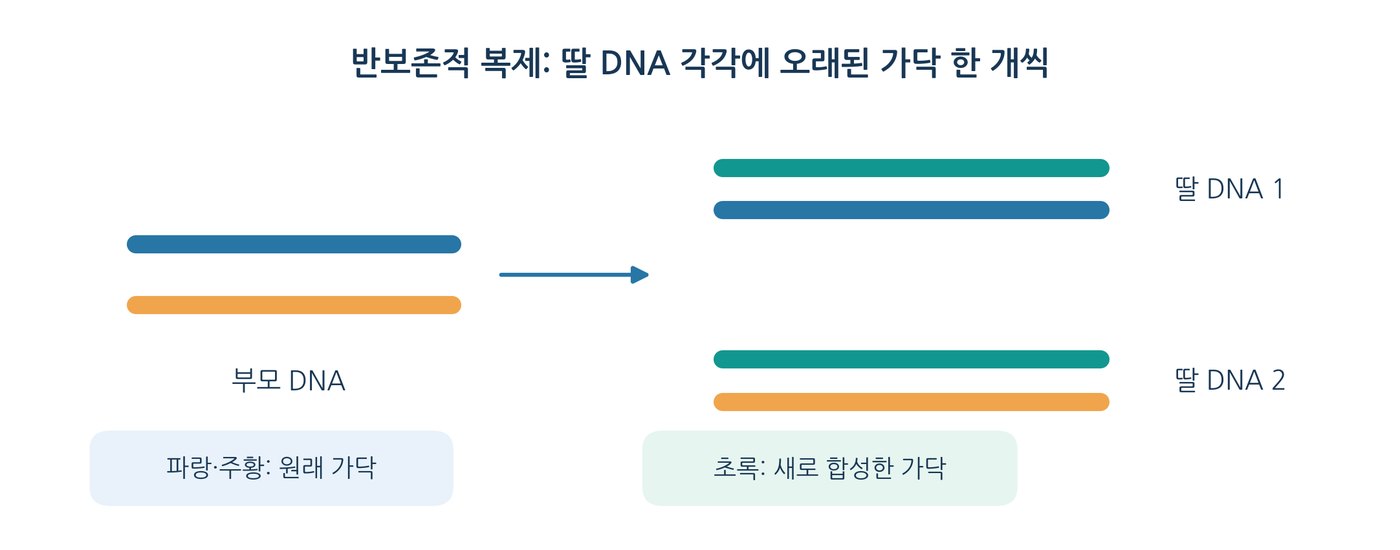
반보존적 복제(semiconservative replication)는 원래 이중가닥 DNA의 두 가닥이 각각 새로운 DNA 합성의 주형이 되는 방식이다. 복제된 두 딸 DNA 분자는 각각 기존 가닥 하나와 새 가닥 하나를 포함한다. 이 구조는 상보적 염기쌍 규칙을 이용해 한 가닥의 정보를 다른 가닥으로 복원할 수 있게 한다.
2.2 메셀슨–스탈 실험은 반보존적 복제를 검증했다
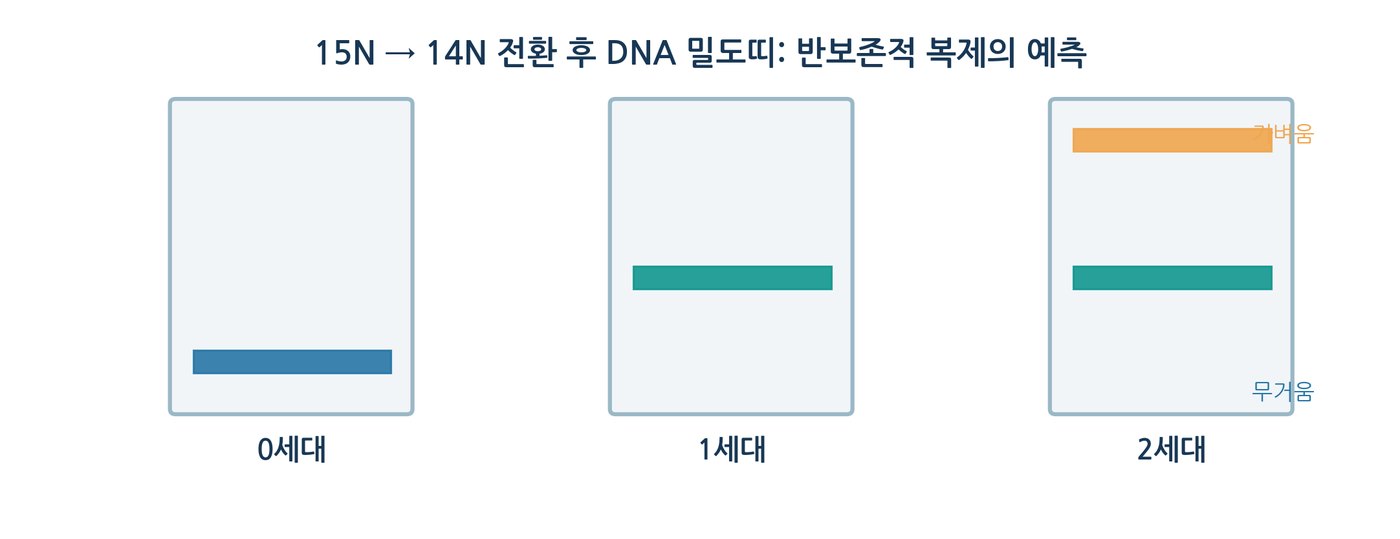
메셀슨과 스탈은 대장균을 무거운 질소 동위원소인 ¹⁵N이 포함된 배지에서 배양해 DNA를 무겁게 표지한 뒤, ¹⁴N 배지로 옮겨 DNA를 복제하도록 했다. 이후 DNA를 추출하여 염화세슘(CsCl) 밀도 기울기 원심분리로 밀도가 다른 DNA를 분리했다. 첫 세대에는 중간 밀도 DNA의 띠만 나타났고, 두 번째 세대에는 중간 밀도와 가벼운 DNA 띠가 나타났다. 이 자료는 반보존적 복제 모형을 지지한다.
표는 원래 DNA가 모두 ¹⁵N으로 표지되어 있고, 이후 복제가 완전히 진행되며 ¹⁴N만 공급된다는 이상적인 반보존적 모형에서 계산한 분자 비율이다. 한 세대 후 결과만으로는 분산적 복제 모형과 확실하게 구별하기 어렵지만, 두 세대 후에 가벼운 띠가 분리되어 나타나는 결과까지 고려하면 분산적 복제 모형과 구별할 수 있다.
2.3 DNA 중합효소는 새 가닥을 5′→3′ 방향으로 합성한다
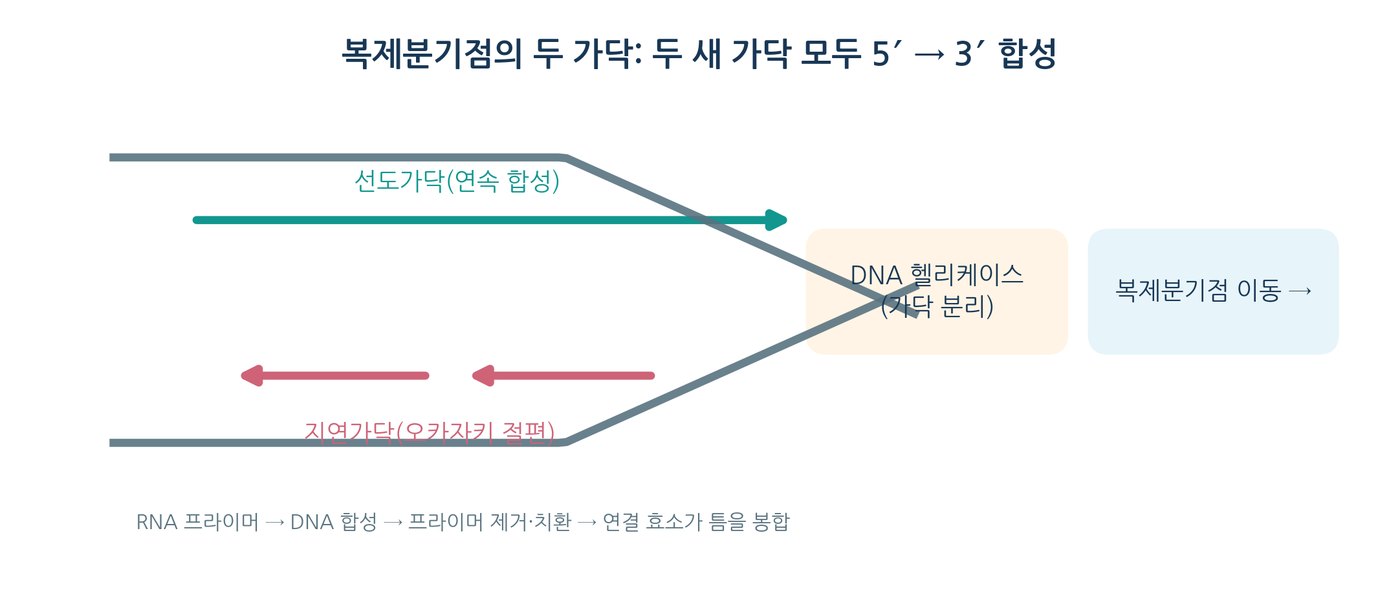
DNA 중합효소(DNA polymerase)는 주형 가닥을 읽으며 들어오는 데옥시리보뉴클레오사이드 삼인산(dNTP)을 성장 중인 DNA 사슬의 3′-OH 말단에 결합시킨다. 들어온 dNTP가 인산다이에스터 결합을 형성할 때 피로인산(PPi)이 이탈하며, PPi의 가수분해는 합성이 진행되는 방향에 기여한다. 대부분의 복제 DNA 중합효소는 완전히 새로운 DNA 가닥을 혼자 시작하지 못하므로, 프라이메이스(primase)가 만든 RNA 프라이머 등 기존의 3′-OH 말단을 필요로 한다.
DNA 가닥 두 개는 역평행하므로 복제분기점(replication fork)에서는 한쪽 새 가닥이 비교적 연속적으로 합성되고, 다른 쪽은 오카자키 절편(Okazaki fragments)으로 불연속 합성된다. 이 둘을 각각 선도가닥(leading strand), 지연가닥(lagging strand)이라고 한다. 어느 가닥이 선도가닥인지는 복제분기점의 진행 방향에 따라 달라진다.
2.4 복제의 시작점과 말단도 중요하다
세균은 보통 특정 복제 시작점에서 복제를 시작하며, 많은 세균의 원형 염색체에서는 두 복제분기점이 서로 반대 방향으로 이동한다. 진핵생물의 긴 선형 염색체에는 복제 시작점이 여러 개 있어, 복제를 가능한 시간 안에 완료할 수 있다. 진핵생물에서는 텔로미어(telomere)가 염색체 끝의 보호에 관여한다. 일부 세포에서는 텔로머레이스(telomerase)가 RNA 주형을 이용해 염색체 말단 반복 서열을 연장하여 말단 복제 문제를 보완한다.
2.5 DNA 복제의 정확성은 여러 단계에서 확보된다
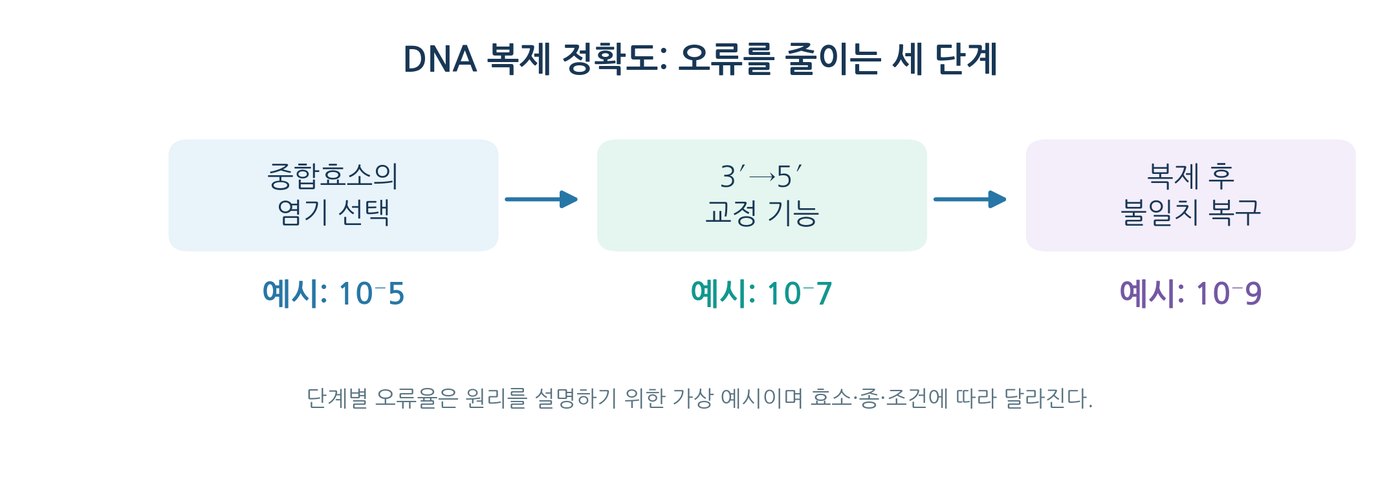
상보적 결합만으로는 복제 오류가 충분히 적어지지 않는다. 중합효소의 활성 부위는 올바른 염기쌍의 기하학적 구조를 선호하고, 많은 복제 중합효소는 잘못 들어간 염기를 3′→5′ 엑소뉴클레이스(exonuclease) 활성으로 제거한다. 복제 후에도 불일치 복구(mismatch repair, MMR)는 남아 있는 부적절한 염기쌍을 인식해 새로 합성된 가닥의 오류 구간을 교정한다.
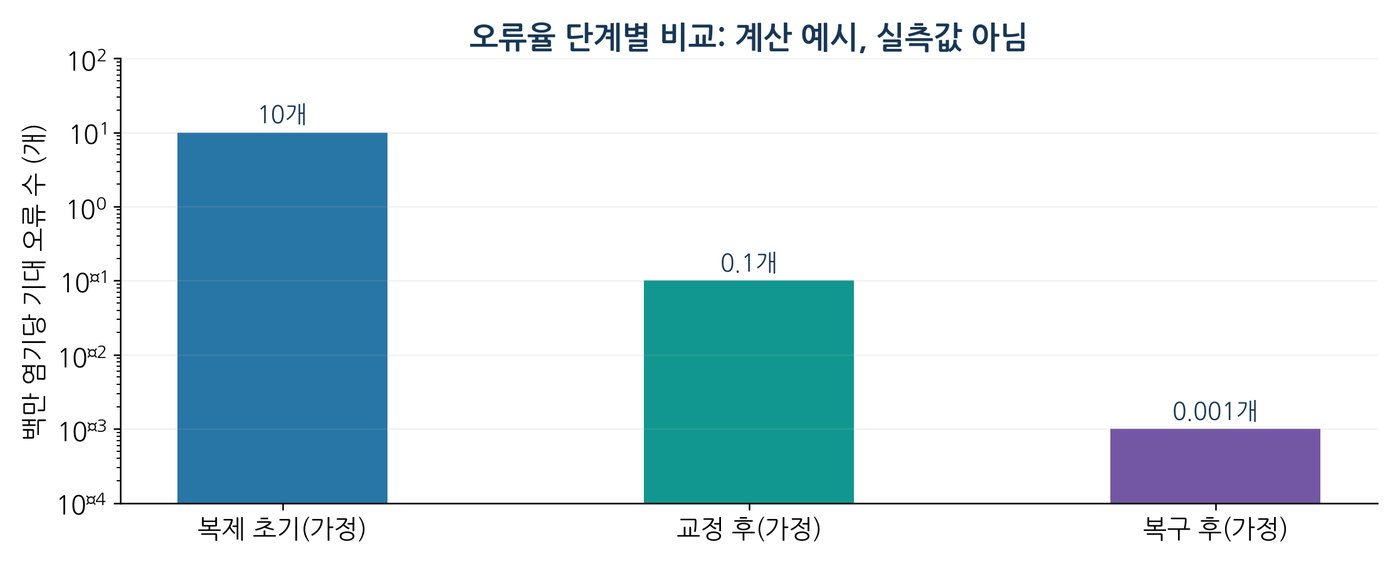
교정 및 복구까지 포함한 복제 오류율은 생물·효소·세포 조건에 따라 다르지만, 고전적인 교재에서는 대략 10⁹~10¹⁰개 염기당 오류 1개 수준으로 설명한다. 이것은 발생 가능한 모든 변이의 실제 빈도가 언제나 같다는 뜻이 아니며, 환경에 의한 손상·세포 분열 횟수·측정 대상에 따라 관찰되는 변이율이 달라진다.
계산 예제 | 확률로 계산하는 복제 오류의 기대값
복제하는 염기의 총수가 N = 4.0 × 10⁶이고, 각 위치의 평균 오류 확률을 p = 1.0 × 10⁻⁹로 가정한다.
오류 수의 기대값 E = Np = 4.0 × 10⁻³개다. 이는 반드시 0.004개의 실제 오류가 생긴다는 의미가 아니라, 매우 많은 같은 조건의 복제를 반복했을 때의 평균값이다.
희귀하고 독립적인 오류라는 이상적 가정을 사용하면 적어도 하나의 오류가 생길 확률 P(≥1) = 1 − (1 − p)^N ≈ 1 − e^(−Np) ≈ 0.0040, 즉 약 0.40%다.
2.6 DNA 손상과 복제 오류는 같은 현상이 아니다
DNA 손상(damage)은 염기 구조의 화학적 변화, 염기 소실, 가닥 절단처럼 DNA 자체의 구조가 훼손된 상태를 말한다. 반면 복제 오류는 주형과 다른 염기가 새 가닥에 잘못 포함된 상태다. 복구되지 않은 손상이 복제 또는 수선 과정을 거치면서 염기 서열의 영구적인 변화, 곧 돌연변이(mutation)로 이어질 수 있다. 그러나 모든 손상이 돌연변이가 되는 것은 아니고, 모든 돌연변이가 외부 유해 물질에 의해 생기는 것도 아니다.
2.7 DNA 복구는 손상 유형에 맞는 분자 기계를 이용한다
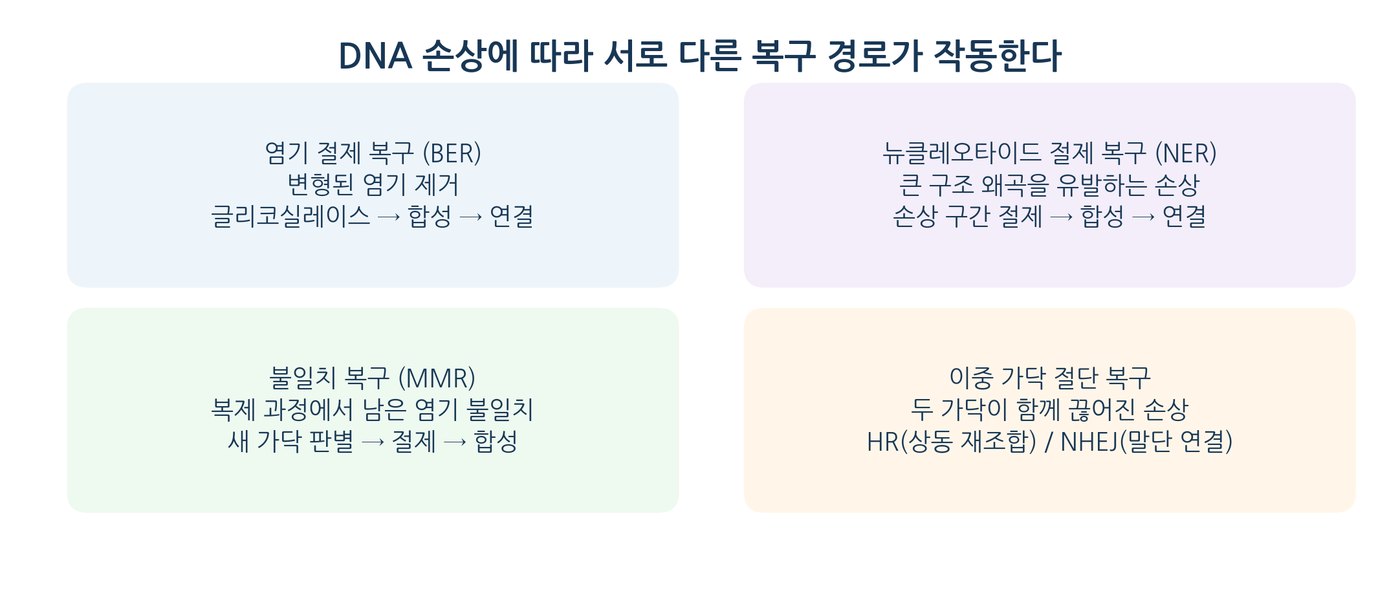
염기 절제 복구(base excision repair, BER)는 DNA 글리코실레이스가 변형된 염기를 인식해 제거하고, 남은 부분을 처리한 뒤 DNA 중합효소와 연결효소가 수선하는 경로다. 뉴클레오타이드 절제 복구(nucleotide excision repair, NER)는 DNA 이중나선의 구조를 크게 왜곡하는 손상을 포함한 일정 길이의 구간을 제거한 다음 정상 가닥을 주형으로 다시 합성한다.
불일치 복구(MMR)는 복제 뒤에 남은 잘못 짝지어진 염기쌍을 바로잡는다. 이중가닥 절단은 상동 서열을 주형으로 사용하는 상동 재조합(homologous recombination, HR) 또는 DNA 말단을 직접 다시 연결하는 비상동 말단 연결(non-homologous end joining, NHEJ) 등의 경로로 처리될 수 있다. 경로에 따라 필요한 효소, 수선 정확성 및 이용 가능한 DNA 주형이 다르다.
2.8 돌연변이는 서열 변화를 뜻하며 결과는 다양하다
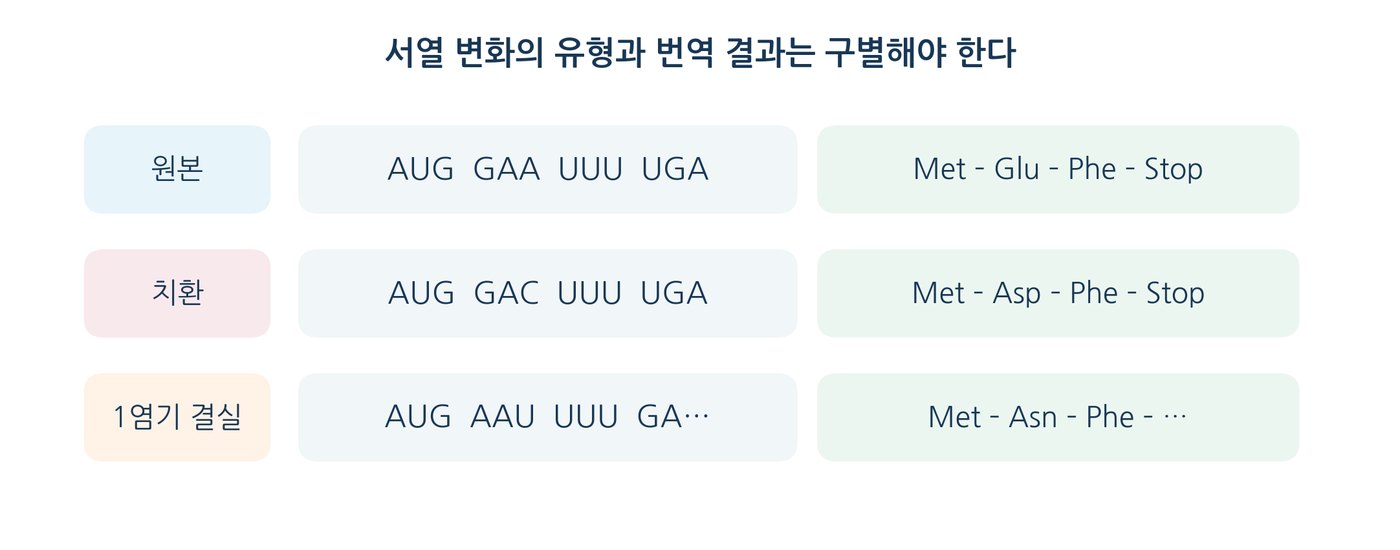
염기 치환(substitution)은 한 염기가 다른 염기로 바뀌는 변화이고, 삽입(insertion)과 결실(deletion)은 염기가 추가되거나 제거되는 변화다. 단백질 암호화 영역에서 한 염기 치환은 아미노산을 바꾸지 않는 동의 변이(synonymous), 아미노산을 바꾸는 미스센스 변이(missense), 종결 코돈을 만드는 넌센스 변이(nonsense) 등을 일으킬 수 있다. 삽입·결실의 길이가 3의 배수가 아니면 일반적으로 읽는 틀이 변하는 프레임이동(frameshift)이 발생한다.
DNA 변이의 영향은 유전자의 위치, 전사·번역에 미치는 효과, 단백질의 구조·기능, 생물의 환경에 따라 달라진다. 어떤 변이는 큰 기능 변화를 일으키지만 어떤 변이는 관찰 가능한 차이가 거의 없다. 생식세포 계열의 변이는 자손에게 전달될 수 있고, 체세포의 변이는 주로 해당 개체의 세포 계통에 영향을 준다.
선형 DNA 서열은 3차원 단백질의 구조와 기능으로 연결된다
3.1 유전정보의 주요 흐름은 DNA → RNA → 단백질이다
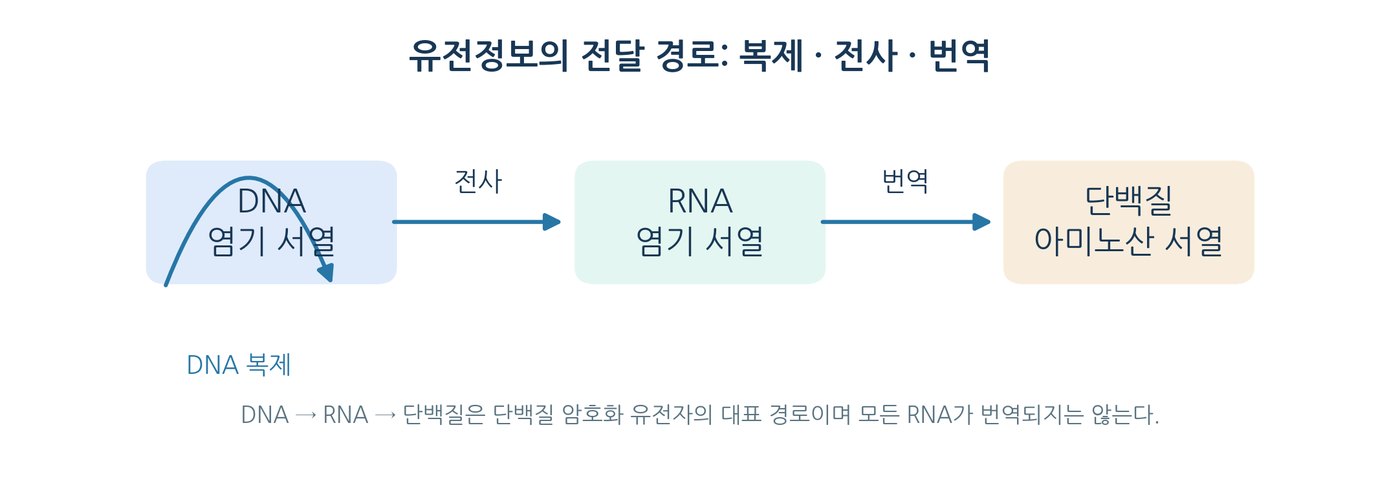
DNA는 정보를 보존하는 주된 매체이고 RNA는 다양한 역할을 하는 중간체 또는 기능성 산물이며, 단백질은 촉매·운반·신호 전달·구조 유지 등을 담당한다. 단백질 암호화 유전자는 DNA 정보가 RNA로 전사(transcription)된 뒤, RNA의 코돈이 아미노산 서열로 번역(translation)되는 경로를 따른다. 이것이 분자생물학의 중심 원리(central dogma)를 설명하는 대표적인 흐름이다.
중심 원리를 모든 정보 이동의 단순한 금지 표처럼 오해해서는 안 된다. 역전사효소에 의한 RNA → DNA 정보 전달이 존재하고, RNA를 유전물질로 사용하는 바이러스도 있다. 또한 tRNA, rRNA 및 조절 RNA처럼 단백질로 번역되지 않고 RNA 자체로 기능하는 유전자 산물도 많다. 핵심은 일반적으로 단백질의 아미노산 서열이 다시 핵산의 염기 서열을 주형에 따라 복원하는 정보 전달 경로로 사용되지 않는다는 점이다.
3.2 전사는 DNA의 한 가닥을 주형으로 RNA를 합성한다
RNA 중합효소는 DNA의 주형 가닥(template strand)을 3′→5′로 읽고 RNA를 5′→3′ 방향으로 합성한다. RNA는 DNA와 달리 리보스를 갖고 티민 대신 유라실(U)을 사용한다. DNA 이중가닥 중 전사에 사용하는 가닥은 해당 유전자와 전사 방향에 따라 결정된다. 전사에 직접 사용되지 않는 코딩 가닥(coding strand)의 염기 서열은 T를 U로 바꾸면 전사된 RNA의 서열과 같다.
전사는 프로모터(promoter) 등 조절 서열에 의해 시작되고, 세포의 조절 인자들이 전사량과 시기를 바꾼다. RNA 중합효소는 DNA 중합효소와 달리 일반적으로 짧은 DNA 또는 RNA 프라이머 없이 전사를 시작할 수 있다. 전사는 DNA를 없애거나 다른 분자로 영구적으로 바꾸는 과정이 아니라 DNA 서열에 대응하는 새로운 RNA를 만드는 과정이다.
3.3 진핵세포의 RNA 가공은 정보의 사용 방식을 바꾼다
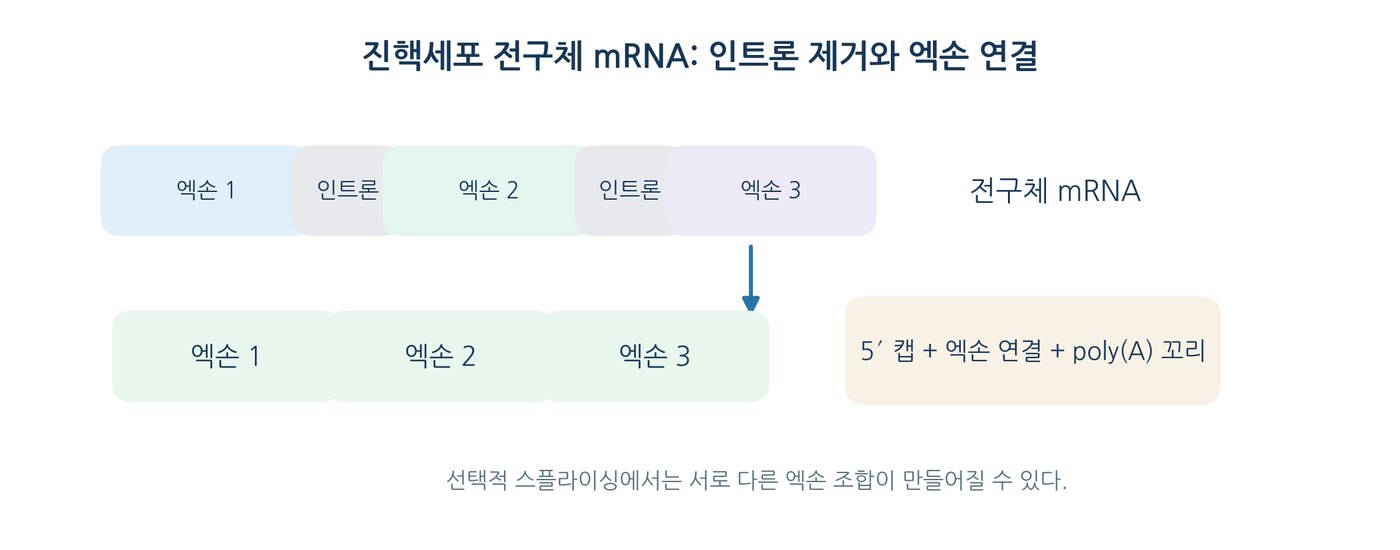
진핵세포의 많은 단백질 암호화 유전자는 엑손(exon)과 인트론(intron)을 포함한다. 전구체 mRNA(pre-mRNA)가 만들어진 뒤에는 대표적으로 5′ 캡 형성, 인트론 제거와 엑손 연결(스플라이싱), 3′ 말단 절단과 poly(A) 꼬리 형성이 일어난다. 이런 과정은 RNA의 안정성, 핵 밖 이동 및 번역 효율에 영향을 줄 수 있다.
선택적 스플라이싱(alternative splicing)이 일어나면 같은 유전자에서 서로 다른 RNA 산물이 만들어질 수 있다. 그러나 모든 유전자에 인트론이 있거나 모든 RNA가 캡·poly(A) 꼬리를 갖는 것은 아니다. RNA 가공의 단계와 방식은 RNA 종류 및 생물에 따라 다르다.
3.4 유전 암호는 세 염기의 조합으로 아미노산을 지정한다
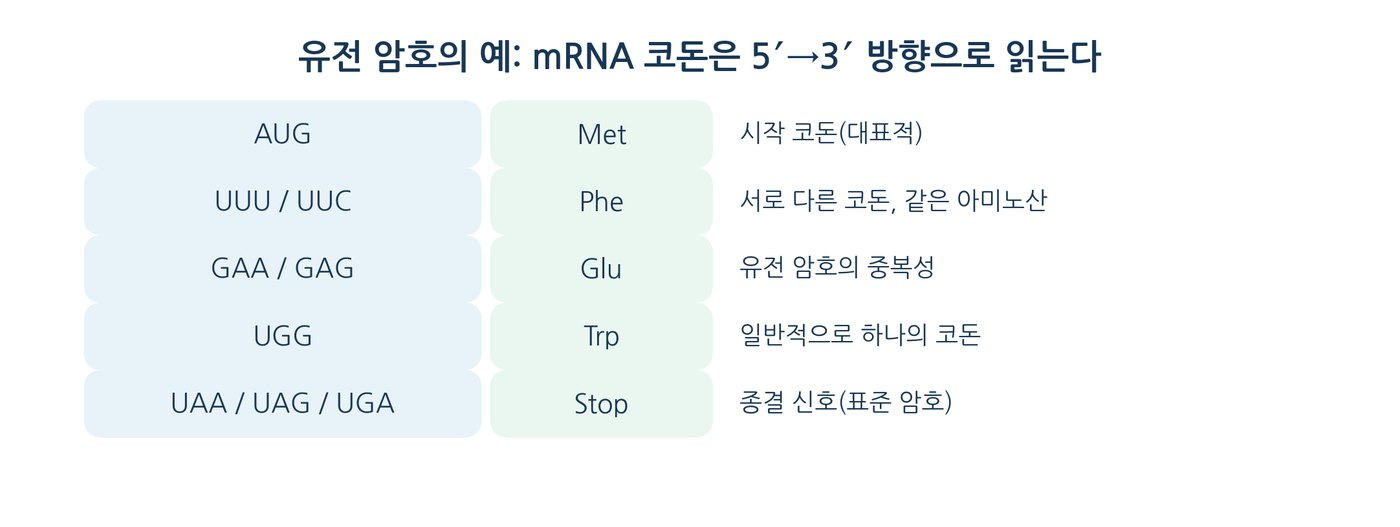
mRNA를 세 염기씩 읽은 단위를 코돈(codon)이라고 한다. RNA 염기는 A·U·G·C 네 종류이므로 가능한 3염기 코돈은 4³ = 64개다. 표준 유전 암호에서 61개는 아미노산을 지정하고 UAA, UAG, UGA의 3개는 종결 신호로 작용한다. AUG는 메티오닌을 지정하며 대표적인 번역 시작 코돈이다. 여러 코돈이 같은 아미노산을 지정하는 성질을 유전 암호의 중복성(degeneracy)이라고 한다.
대부분의 생명체는 거의 같은 유전 암호를 사용하지만, 일부 미토콘드리아 및 특정 생물에서는 코돈의 뜻이 표준 암호와 다를 수 있다. 또한 시작 코돈 인식에는 코돈 자체뿐 아니라 주변 서열과 번역 개시 인자가 함께 관여한다. 코돈은 반드시 5′→3′ 방향으로 읽어야 하고 번역 개시 위치가 달라지면 읽는 틀(reading frame)도 달라진다.
3.5 리보솜과 tRNA가 코돈을 아미노산 서열로 해독한다
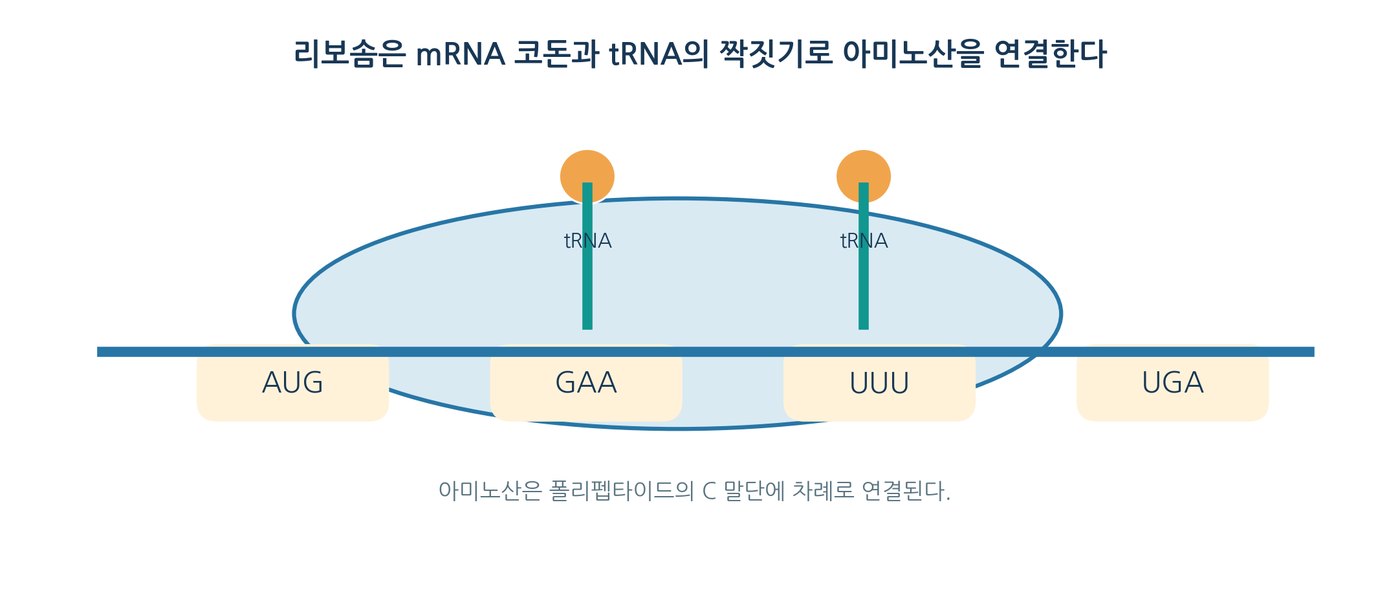
tRNA(운반 RNA)는 코돈에 대응하는 안티코돈(anticodon)을 갖고 있으며 자신의 3′ 말단에 특정 아미노산을 결합시킨다. 아미노아실-tRNA 합성효소(aminoacyl-tRNA synthetase)는 적절한 아미노산을 해당 tRNA에 연결하는 데 중요한 역할을 한다. 리보솜은 mRNA를 5′→3′로 읽으며 tRNA에 실려 온 아미노산을 결합시켜 폴리펩타이드를 N 말단에서 C 말단 방향으로 연장한다.
리보솜은 큰 소단위체와 작은 소단위체로 이루어지며, 펩타이드 결합 형성의 중심에는 리보솜 RNA(rRNA)가 있다. 시작, 신장, 종결에는 여러 단백질 인자와 GTP 등의 에너지 자원이 관여한다. 종결 코돈이 번역의 해독 자리로 들어오면 방출 인자(release factor)가 작용하여 폴리펩타이드가 분리된다.
계산 예제 | DNA 서열에서 아미노산 서열까지
예: DNA 코딩 가닥이 5′-ATG GAA TTT TGA-3′라고 하자. 이 유전자의 전사와 번역이 제시된 읽는 틀대로 이루어진다고 가정한다.
mRNA는 5′-AUG GAA UUU UGA-3′이고, AUG = 메티오닌(Met), GAA = 글루탐산(Glu), UUU = 페닐알라닌(Phe), UGA = 종결이므로 폴리펩타이드 서열은 Met–Glu–Phe가 된다.
종결 코돈은 어떤 아미노산을 지정하는 것이 아니라 번역을 멈추게 하는 신호이므로 아미노산 서열에 “Stop”을 하나의 잔기처럼 포함하지 않는다.
3.6 단백질의 3차원 구조는 아미노산 서열과 환경이 함께 결정한다
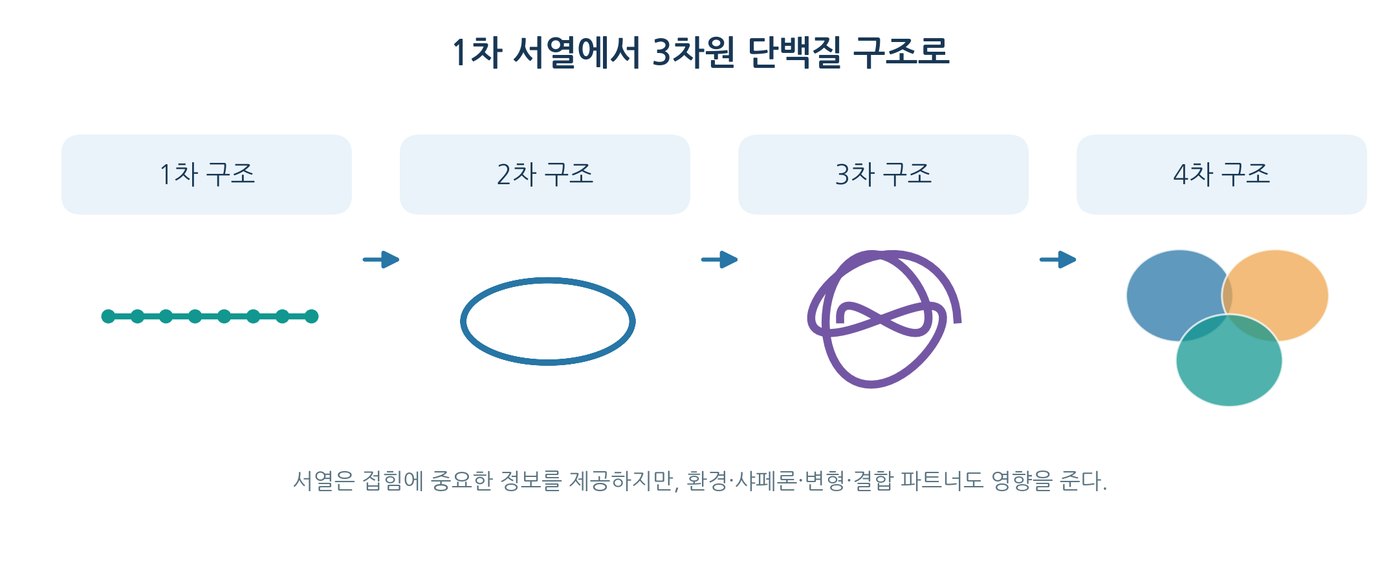
1차 구조(primary structure)는 폴리펩타이드의 아미노산 배열 순서다. 펩타이드 주사슬 사이의 수소 결합은 α-나선과 β-병풍 등 대표적인 2차 구조를 안정화한다. 하나의 폴리펩타이드가 전체적으로 접힌 공간 배열은 3차 구조이고, 여러 폴리펩타이드 소단위체가 결합한 구조는 4차 구조다. 모든 단백질이 네 가지 수준을 반드시 모두 갖는 것은 아니다.
단백질 접힘(folding)은 아미노산 서열에 의존하지만, 이를 “서열만 알면 항상 하나의 고정된 모양이 자동으로 결정된다”라고 단순화할 수는 없다. 수용액의 pH와 이온 강도, 온도, 산화·환원 환경, 결합하는 리간드, 세포 내 샤페론(chaperone) 등이 실제 구조·안정성에 영향을 준다. 어떤 단백질은 기능을 수행할 때 구조를 계속 바꾸고, 안정된 단일 3차 구조를 갖지 않는 내재적 무질서 영역도 존재한다.
3.7 유전자 변이는 단백질 기능을 바꿀 수 있지만 언제나 그러지는 않는다
특정 염기가 바뀌더라도 동일한 아미노산이 암호화되면 아미노산 서열에 변화가 없을 수 있다. 반면 아미노산 하나가 바뀌면 단백질 내부의 전하 분포, 수소 결합, 소수성 상호작용 등이 달라질 수 있어 접힘이나 활성이 변할 수 있다. 조기 종결 또는 읽는 틀 변화는 폴리펩타이드 길이와 후반부 서열을 크게 바꿀 수 있다. 그러나 이러한 영향의 크기는 변이의 위치와 단백질의 구조·기능에 달려 있다.
예를 들어 낫모양적혈구병과 관련된 성인 헤모글로빈의 β-글로빈 단백질에서는 하나의 아미노산이 글루탐산에서 발린으로 바뀐다. 이 변화는 헤모글로빈 분자 사이 상호작용을 바꾸고 특정 조건에서 섬유 형성을 촉진한다. 이 사례는 단 한 개의 아미노산 치환이 단백질의 물성과 세포의 형질에 영향을 미칠 수 있음을 보여 주지만, 모든 아미노산 변화가 같은 정도의 결과를 낳는 것은 아니다.
3.8 같은 DNA라도 유전자 발현 양상이 다르면 세포 기능이 달라진다
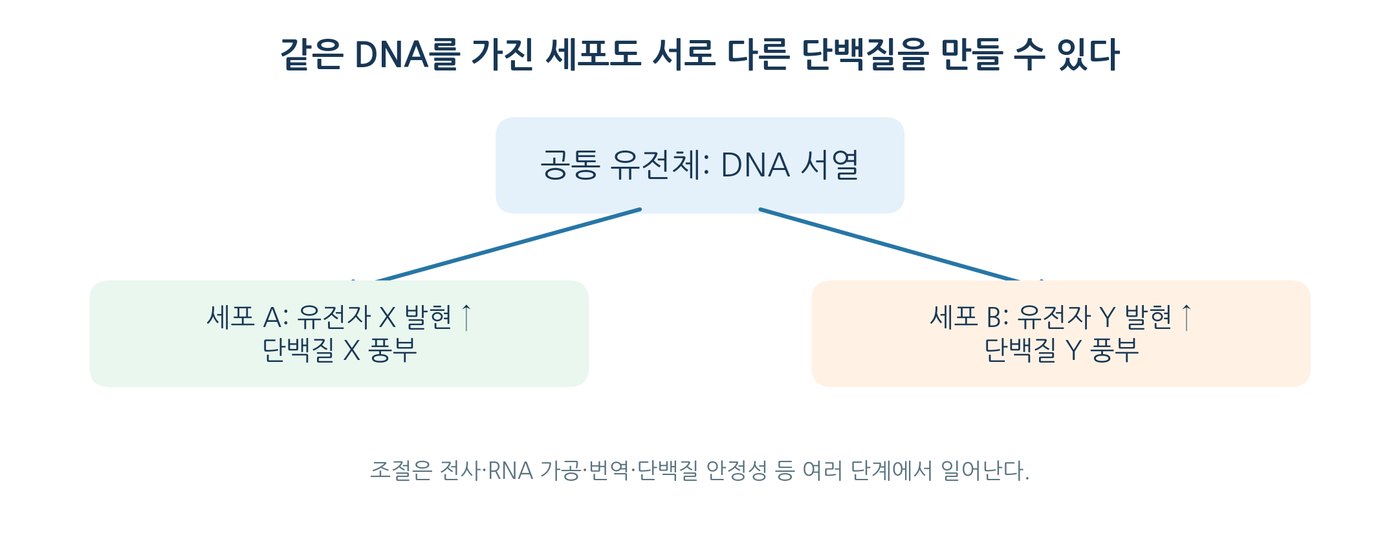
다세포생물의 서로 다른 세포는 일반적으로 매우 비슷한 핵 유전체를 공유하지만, 세포 유형에 따라 발현하는 유전자와 만들어지는 단백질의 종류·양이 다르다. 유전자 발현은 DNA 접근성, 전사 개시, RNA 가공과 안정성, 번역 효율, 단백질의 변형과 분해 등 여러 수준에서 조절된다. 따라서 ‘DNA 서열 → 단백질 서열 → 기능’의 연결은 단순한 일방통행이 아니라 조절 네트워크와 환경의 영향을 받는 동적 과정이다.
탐구 활동: 유전정보의 보존과 발현을 검증하는 모형
탐구 A | 메셀슨–스탈 실험 자료로 복제 모형 검증하기
탐구 질문은 “¹⁴N 배지에서 1세대와 2세대 DNA 밀도띠의 조합은 보존적·반보존적·분산적 복제 중 어느 모형을 지지하는가?”이다. 준비물은 두 가지 색의 종이띠, 펜, 가위, 투명 테이프다. 교사가 제시한 모형에 따라 한 DNA 분자를 두 가닥 종이띠로 나타내고, 복제 1·2·3세대 후 분자 조성을 기록한다.
- ① 원래 DNA의 두 가닥에 H(¹⁵N)를 쓰고, 복제할 때 새로 합성되는 가닥에는 L(¹⁴N)를 표시한다.
- ② 반보존적 복제 원리에 따라 1·2·3세대에 생기는 HH·HL·LL 분자의 수를 추론한다.
- ③ 보존적 복제 모형이라면 첫 세대에 어떤 두 띠가 나와야 하는지 예측한다.
- ④ 실제로 보고된 관찰 특징(첫 세대는 중간 밀도 띠 하나, 둘째 세대는 중간+가벼운 띠)을 모형별 예측과 비교한다.
해석할 점: 실험은 DNA를 직접 사진으로 관찰한 것이 아니라 동위원소 표지에 따른 밀도 차이를 근거로 복제 모형을 판별한 연구다. 종이 모형은 분자 수 비율을 확인하기 위한 활동이며 실제 실험값은 아니다.
탐구 B | DNA 오류율을 확률 모델로 해석하기
탐구 질문은 “오류 확률이 100배 낮아지면 수백만 염기를 복제할 때 기대 오류 수가 얼마나 감소하는가?”이다. 염기 개수 N = 2.0 × 10⁶, 복제 오류 확률 p = 10⁻⁵, 10⁻⁷, 10⁻⁹를 각각 대입한다.
모형의 한계: 염기마다 오류가 독립적으로 발생하고 확률이 같다고 가정했다. 실제 DNA 복제에서는 염기 조성, 서열 문맥, 중합효소의 특성, 수선 경로 및 생물 종에 따라 오류율이 다르다. 표와 그래프의 수치는 이론적 예제다.
탐구 C | 서열 하나가 바뀌면 아미노산과 구조는 어떻게 달라질까?
기준 mRNA는 5′-AUG GAA UUU UGA-3′이다. 이를 코돈표로 번역한 뒤 두 변이와 비교한다. 첫째는 GAA가 GAC로 바뀌는 단일 염기 치환이고, 둘째는 시작 코돈 다음의 G 한 개가 삭제되는 변이다. 원본과 변이의 코돈 경계를 직접 표시하고 종결 코돈의 위치 변화를 분석한다.
결론 작성 과제: ① 코돈 중복성 때문에 모든 치환이 아미노산을 바꾸는 것은 아님을 설명한다. ② 결실에 따른 읽는 틀 변화가 왜 뒤따르는 많은 코돈에 영향을 줄 수 있는지 서술한다. ③ 단백질의 아미노산 서열만 보고 기능 변화의 크기를 단정할 수 없는 이유를 설명한다.
선택 실험 | 과일 조직의 DNA 침전 관찰
준비물: 딸기 또는 바나나 약 20 g, 물 40 mL, 주방 세제 3 mL, 소금 약 0.5 g, 여과지, 비커, 투명 시험관, 차갑게 보관한 에탄올(지도교사 관리). 과일을 으깬 뒤 물·세제·소금 용액을 섞어 세포막을 파괴하고, 여과액 위에 차가운 에탄올을 조심스럽게 층을 이루도록 넣는다. 경계면에 생성되는 흰 침전물을 관찰한다. 이 침전물은 DNA가 풍부할 수 있으나 RNA·단백질 등 다른 성분이 함께 포함될 수 있어 ‘순수 DNA가 보인다’고 단정하지 않는다.
핵심 개념 정리
교재 활용 안내와 참고 자료
수업 운영 제안
본 단원은 ① DNA 정보의 조직화와 복제(2차시), ② 복제 정확도·손상 복구와 계산(2차시), ③ 전사·번역·단백질 구조(2차시), ④ 모형 탐구 및 평가(2차시) 등 총 8차시의 기본 수업으로 편성할 수 있다. 화학 중심 수업에서는 인산다이에스터 결합, 염기 간 상호작용, 효소 촉매와 자유에너지의 관점을 다시 연결한다. 계산 활동은 학생 수준에 따라 심화 또는 선택 과제로 운영할 수 있다.
표기·그림·자료의 사용 범위
DNA·RNA 및 아미노산 서열은 방향성(5′→3′, N→C)을 확인하여 읽는다. 본문 도식 그림 1-40~1-54는 교재를 위해 새로 제작한 교육용 모형이다. 단계별 복제 오류율 그래프와 기대값 표는 계산의 원리를 설명하기 위한 가상 조건이며 실제 실험 자료가 아니다. 표지 그림은 생성형 이미지로 제작한 이미지이며 특정 분자의 구조 분석 결과가 아니다.
참고 자료
부록 | 표준 유전 암호 전체 코돈표
표준 유전 암호를 mRNA의 5′→3′ 방향으로 읽는 빠른 확인표다. 왼쪽 열의 두 염기는 코돈의 1·2번째 위치, 위쪽 열은 3번째 염기를 나타낸다. 이 표는 표준 암호에 해당하며 일부 미토콘드리아·생물에서는 예외가 존재한다.
| 용어 | 중심 의미 | 예시와 구별점 |
|---|---|---|
| 뉴클레오타이드 | 염기·당·인산으로 된 기본 단위 | DNA의 A·T·G·C 뉴클레오타이드 |
| 유전자 | 기능성 산물과 관련된 DNA 구간 | 단백질 암호화 유전자, rRNA 유전자 |
| 염색체 | 조직화된 DNA의 전달 단위 | 복제 전 사람 염색체 하나: 연속 DNA 분자 하나 |
| 유전체 | 전체 유전정보의 집합 | 핵 DNA뿐 아니라 해당되는 소기관 DNA 고려 |
| 플라스미드 | 염색체와 구별되는 독립 복제 DNA 요소 | 일부 세균의 항생제 내성 관련 유전자 보유 |
| 목차의 표현을 정확히 해석하기 “유전적 연속성은 단일 DNA 분자에 부여된다”는 문장은 개별 염색체 DNA의 연속성과 복제 가능성을 강조한 표현으로 이해하는 것이 적절하다. 모든 생명체의 유전정보가 단 하나의 DNA 분자에만 저장된다는 뜻은 아니다. 일부 바이러스는 DNA 대신 RNA를 유전물질로 사용한다. |
|---|
| ¹⁴N 배지로 옮긴 뒤 | 무거운 DNA(HH) | 혼성 DNA(HL) | 가벼운 DNA(LL) |
|---|---|---|---|
| 0세대 | 100% | 0% | 0% |
| 1세대 | 0% | 100% | 0% |
| 2세대 | 0% | 50% | 50% |
| 3세대 | 0% | 25% | 75% |
| 구성 요소 | 주요 역할 | 생화학적 핵심 |
|---|---|---|
| DNA 헬리케이스 | 이중가닥 분리 | 복제분기점에서 DNA 가닥을 벌림 |
| 토포아이소머레이스 | DNA 비틀림 완화 | 복제 전방의 꼬임과 위상 문제를 처리 |
| 단일가닥 DNA 결합 단백질 | 노출된 단일가닥 보호 | 재결합·분해 및 비정상 구조 형성 감소 |
| 프라이메이스 | 짧은 프라이머 합성 | 중합효소에 필요한 3′-OH 말단 제공 |
| DNA 중합효소 | 새 가닥 합성 및 일부 교정 | 주형에 상보적인 dNTP를 5′→3′ 연결 |
| 프라이머 제거·치환 인자 | RNA 프라이머 처리 | 해당 구간을 DNA로 대체 |
| DNA 연결효소 | 절편 사이 틈 봉합 | 인산다이에스터 결합 형성 |
| 더 정확히 알기 텔로머레이스가 모든 체세포에서 같은 정도로 활성화되는 것은 아니다. 또한 텔로머레이스는 전체 염색체를 복제하는 일반 DNA 중합효소가 아니라, 자신의 RNA를 주형으로 DNA를 연장하는 특수한 역전사효소다. |
|---|
| 원인 또는 상황 | DNA 수준에서 일어나는 변화 | 대표적인 후속 대응 |
|---|---|---|
| 자외선(UV) | 인접 피리미딘 사이의 비정상적 공유 결합 형성 | 뉴클레오타이드 절제 복구 |
| 자발적 염기 탈아미노화 | 시토신 등이 다른 염기로 화학적 변화 | 염기 절제 복구 |
| 산화 스트레스 | 산화된 염기·가닥 손상 형성 | 염기 절제 복구 등 |
| DNA 합성 오류 | 주형과 맞지 않는 염기쌍 형성 | 교정 기능·불일치 복구 |
| 이중가닥 절단 | DNA 두 가닥이 함께 절단 | 상동 재조합 또는 비상동 말단 연결 |
| 오해하지 않기 DNA 복구는 “항상 완벽한 원상 복구”가 아니다. 복구 경로 선택과 손상 상태에 따라 원래 서열이 보존되기도 하지만, 일부 복구는 염기 삽입·결실 또는 재배열을 남길 수 있다. |
|---|
| 구조 수준 | 중심 개념 | 관여하는 대표 요소 |
|---|---|---|
| 1차 구조 | 아미노산의 공유 결합 배열 | 펩타이드 결합과 서열 |
| 2차 구조 | 주사슬의 국소 규칙 구조 | 수소 결합, α-나선, β-병풍 |
| 3차 구조 | 한 사슬의 전체적인 접힘 | 소수성 효과, 수소 결합, 이온 상호작용, 이황화 결합 |
| 4차 구조 | 여러 폴리펩타이드의 결합 | 소단위체 간 비공유 결합 또는 일부 공유 결합 |
| 핵심 정리 유전정보는 DNA의 염기 서열에 비교적 안정하게 저장되고, 복제·교정·복구로 전달 정확도가 높아진다. 정보의 발현은 전사·RNA 가공·번역을 거쳐 단백질의 구조와 기능으로 연결되며, 세포의 환경과 조절 상태가 실제 결과를 결정한다. |
|---|
| 관찰/예측 | 1세대 | 2세대 | 3세대 |
|---|---|---|---|
| 반보존적 모형의 HL 비율 | 100% | 50% | 25% |
| 반보존적 모형의 LL 비율 | 0% | 50% | 75% |
| 원자료와 비교할 특징 | 중간 띠 하나 | 중간+가벼운 띠 | 가벼운 띠 비율 증가 |
| 평균 오류 확률 p | 백만 염기당 기대 오류 수 | N = 2 × 10⁶일 때 기대 오류 수 |
|---|---|---|
| 10⁻⁵ | 10개 | 20개 |
| 10⁻⁷ | 0.1개 | 0.2개 |
| 10⁻⁹ | 0.001개 | 0.002개 |
| 서열 유형 | mRNA(5′→3′) | 번역 결과 |
|---|---|---|
| 기준 | AUG GAA UUU UGA | Met–Glu–Phe–Stop |
| 치환 | AUG GAC UUU UGA | Met–Asp–Phe–Stop |
| 1염기 결실 | AUG AAU UUU GA… | Met–Asn–Phe–… |
| 핵심 용어 | 한 문장으로 정리 |
|---|---|
| 역평행·상보성 | 두 DNA 가닥은 반대 방향이며 A–T, G–C 짝짓기로 주형 복제가 가능하다. |
| 반보존적 복제 | 딸 DNA는 각각 기존 가닥 한 개와 새로운 가닥 한 개를 가진다. |
| 복제 정확성 | 염기 선택·교정·불일치 복구가 복제 오류를 대폭 줄인다. |
| DNA 손상 복구 | 손상 유형에 맞는 BER·NER·HR·NHEJ 등의 경로가 작용한다. |
| 전사 | DNA 주형에 따라 RNA를 5′→3′로 합성한다. |
| 번역 | 리보솜이 mRNA 코돈을 해독하여 폴리펩타이드를 합성한다. |
| 단백질 접힘 | 서열과 환경이 함께 3차원 구조와 동적 기능을 결정한다. |
| 1·2번째 염기 | 3번째 U | 3번째 C | 3번째 A | 3번째 G |
|---|---|---|---|---|
| UU | UUU · Phe | UUC · Phe | UUA · Leu | UUG · Leu |
| UC | UCU · Ser | UCC · Ser | UCA · Ser | UCG · Ser |
| UA | UAU · Tyr | UAC · Tyr | UAA · Stop | UAG · Stop |
| UG | UGU · Cys | UGC · Cys | UGA · Stop | UGG · Trp |
| CU | CUU · Leu | CUC · Leu | CUA · Leu | CUG · Leu |
| CC | CCU · Pro | CCC · Pro | CCA · Pro | CCG · Pro |
| CA | CAU · His | CAC · His | CAA · Gln | CAG · Gln |
| CG | CGU · Arg | CGC · Arg | CGA · Arg | CGG · Arg |
| AU | AUU · Ile | AUC · Ile | AUA · Ile | AUG · Met |
| AC | ACU · Thr | ACC · Thr | ACA · Thr | ACG · Thr |
| AA | AAU · Asn | AAC · Asn | AAA · Lys | AAG · Lys |
| AG | AGU · Ser | AGC · Ser | AGA · Arg | AGG · Arg |
| GU | GUU · Val | GUC · Val | GUA · Val | GUG · Val |
| GC | GCU · Ala | GCC · Ala | GCA · Ala | GCG · Ala |
| GA | GAU · Asp | GAC · Asp | GAA · Glu | GAG · Glu |
| GG | GGU · Gly | GGC · Gly | GGA · Gly | GGG · Gly |